어떤 프로젝트인가요?
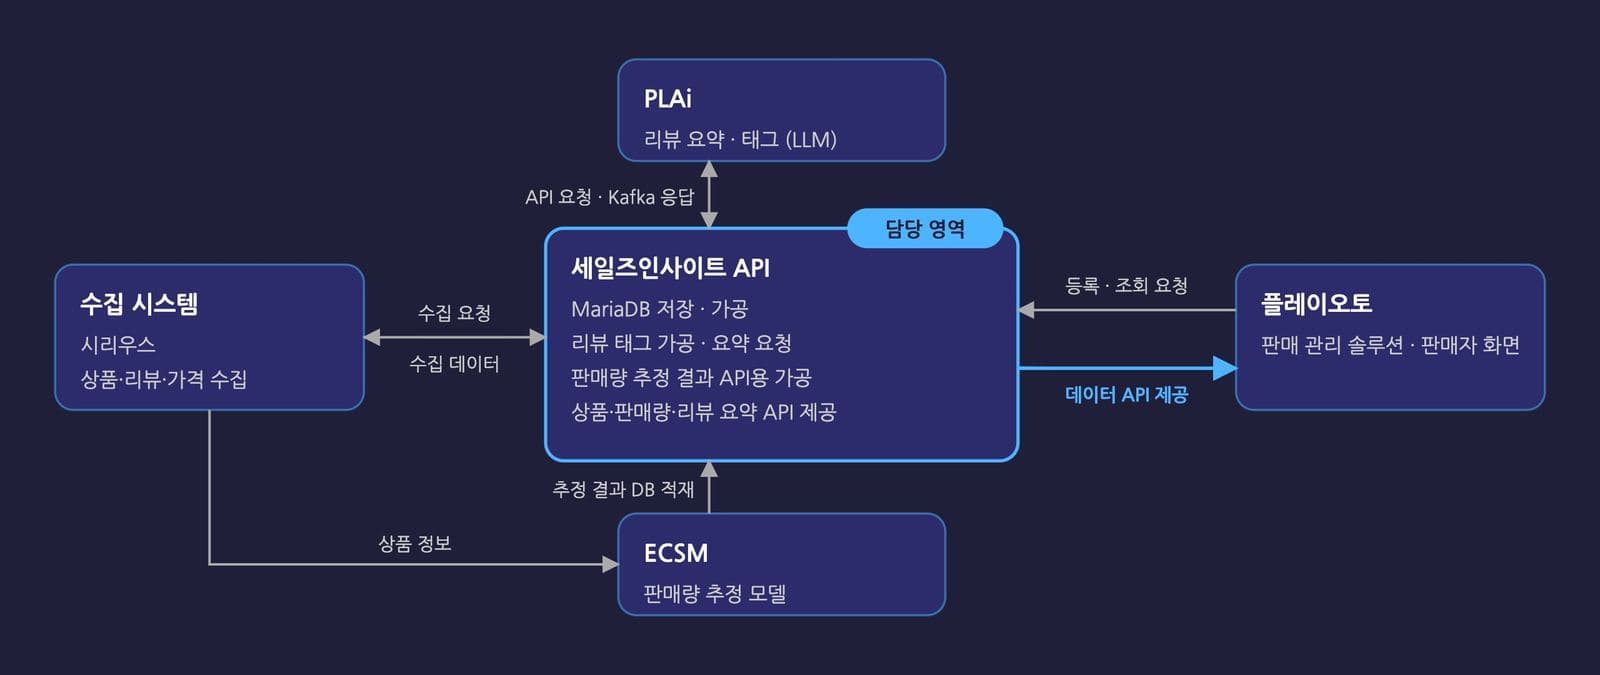
- 플레이오토가 세일즈인사이트 API(담당 영역)에 상품 등록·조회를 요청하는 것에서 시작한다.
- 세일즈인사이트 API가 수집 시스템(시리우스)에 상품 수집을 요청하고, 수집된 상품·리뷰·가격 데이터를 MariaDB에 저장해 가공한다.
- 수집 시스템은 수집한 상품 정보를 ECSM에도 넘기고, ECSM은 판매량 추정 결과를 DB에 직접 적재한다. 세일즈인사이트 API가 이를 API용 데이터로 가공한다.
- 리뷰를 전처리해 PLAi에 태그 추출·요약을 API로 요청하고, 결과는 Kafka로 비동기 수신해 긍정·부정 요약으로 저장한다.
- 상품·판매량·리뷰 요약을 REST API로 플레이오토에 제공하고, 판매자는 플레이오토 화면에서 이 정보를 본다.
세일즈인사이트는 상품 가격 변화, 리뷰 분석, 예상 판매량 데이터를 판매 관리 솔루션(플레이오토)에 제공하는 B2B API 서비스입니다. 판매자는 플레이오토 화면에서 이 정보를 봅니다.
저는 빌트온에서 백엔드를 혼자 맡아, 이 정보를 만들어 플레이오토에 제공하는 역할을 했습니다. 수집 시스템이 모은 상품·리뷰·가격 데이터를 저장하고 가공한 뒤, AI 분석 시스템(PLAi)의 리뷰 요약과 판매량 추정 시스템(ECSM)의 결과까지 각각 플레이오토가 바로 쓸 수 있는 API로 전달했습니다. 서로 다른 회사의 시스템 4개가 얽혀 있어, 한 곳의 장애가 번지지 않도록 경계를 나누고 인터페이스를 명확히 정의하는 것이 핵심 과제였습니다.
세부 내용
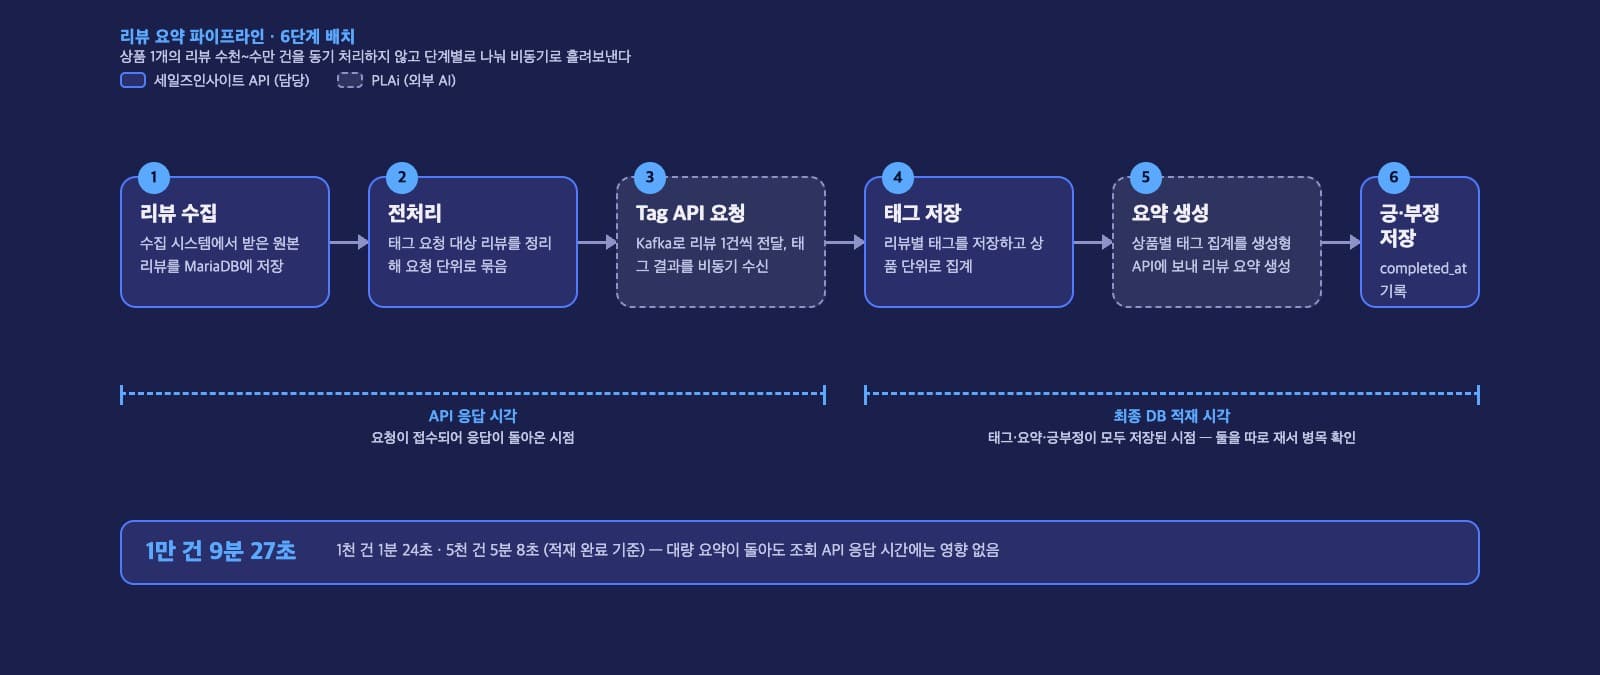
리뷰 1만 건 AI 태그 생성을 9분 27초에 처리하는 비동기 파이프라인 (1천 건 1분 24초 · 5천 건 5분 8초)
어떤 고민이 있었는가
- 상품당 수천~수만 건의 리뷰를 AI로 요약하는 작업은 동기 처리할 수 없는 규모였습니다. PLAi 서버 상태에 따라 요청 완료까지 4~6초, Kafka로 결과를 받기까지 11~17초가 걸려 API 응답 시점과 실제 DB 적재 완료 시점이 달랐고, "얼마나 걸리는가"의 측정 기준부터 모호했습니다.
어떻게 해결했는가
- Start: 배치가 review_master에서 summary_result에 없는 pk의 리뷰를 가져오고, 리뷰 없음·5글자 이하를 제외해 Tag API 입력 형태로 바꾼다.
- 1단계(리뷰 1건씩): PLAi Tag API에 요청(use_async · use_each · kafka_key=pk)하고 결과를 Kafka로 받는다. 태그가 추출되면 긍정·부정 태그와 근거 문장(tag_phrase)을 review_tag에 저장하고, 추출되지 않으면 건너뛴다. 남은 리뷰가 있으면 반복한다.
- 2단계(상품 1건씩): review_tag를 상품별로 {tag, count}로 집계해 PLAi Summary Generate API에 요청하고, Kafka로 받은 긍정·부정 요약을 summary_result에 저장한다.
- review_master.completed_at을 갱신해 다음 배치에서 제외하고, 저장된 요약은 리뷰 요약 조회 API로 플레이오토에 제공한다. 남은 상품이 있으면 반복한다.
- 측정(운영 로그): 리뷰 1천 건은 API 응답 6초·적재 완료 1분 43초, 1만 건은 API 응답 7초·적재 완료 11분 33초(태그 2,788개 생성).
- 2단계 구조로 나눴습니다. 1단계는 리뷰 1건씩 PLAi Tag API에 보내 긍정·부정 태그와 근거 문장(tag_phrase)을 추출해 review_tag에 저장하고, 2단계는 상품별로 태그를 {tag, count}로 집계해 Summary Generate API에 보내 긍정·부정 요약을 summary_result에 저장합니다. 요약 입력이 리뷰 수가 아니라 태그 종류 수만큼만 들어가 비용과 시간이 줄어듭니다.
- 요청은 API로 보내고 결과는 Kafka로 비동기 수신합니다(use_async · kafka_key=pk). 처리 완료는 review_master.completed_at으로 기록해, 배치는 summary_result에 없는 pk만 다시 가져옵니다.
- 리뷰 1천·5천·1만 건 테스트에서 API 응답 시간과 최종 DB 적재 시간을 분리 측정하고, 재시도 단계별 건수·태그 생성 건수·제외 건수(리뷰 없음·5글자 이하)를 함께 기록했습니다.
결과
- 1만 건 기준 최종 적재 완료 9분 27초(1천 건 1분 24초 · 5천 건 5분 8초)로, 대량 요약이 서비스 응답 시간에 영향을 주지 않습니다. 적재 완료 시점(completed_at)을 기준으로 리뷰 요약 조회 API가 결과를 제공합니다.
수집 상태 추적과 3단계 재시도로 1만 건 부하 테스트 API 요청 실패 0건
어떤 고민이 있었는가
- 외부 AI API 호출이 일시적으로 실패하면 그 건은 빠지고, 어느 단계에서 왜 실패했는지 구분되지 않았습니다.
- 수집·AI 분석·판매량 추정·제공이 모두 다른 시스템에서 이루어지는 구조라, 시스템마다 역할과 요청·응답 흐름을 먼저 정리하지 않으면 마지막 통합 단계에서 문제가 터질 것이 분명했습니다.
어떻게 해결했는가
- Start: 플레이오토가 상품 URL을 입력해 API를 요청한다.
- URL 형식이 올바르지 않으면 400 Bad Request(올바른 URL 형식을 입력해주세요.), 수집 가능 쇼핑몰이 아니면 400 Bad Request(지원하지 않는 쇼핑몰입니다.), 수집 가능 상품이 아니면 400 Bad Request(상품 ID를 식별할 수 없습니다.)로 응답하고 종료한다.
- 이미 등록된 URL이면 409 Conflict(이미 등록된 상품 URL입니다.)로 응답하고 종료한다.
- 처음 등록하는 URL이면 PK를 생성해 status 0(수집 중)으로 api_master에 저장하고, 즉시 발행 스케줄(group_id · mall · mall_pid · keep{url, pk})을 만든 뒤 201 Created(수집 상품이 등록되었습니다.)로 바로 응답하고 종료한다.
- 처리 중 예외가 나면 어느 단계에서든 500 Internal Server Error(서버 오류)로 응답하고 종료한다.
- 응답 이후 스케줄이 수집 엔진(시리우스)에게 즉시 수집을 요청하고, 수집 데이터가 product_master에 저장되었는지 확인한다.
- 저장되었으면 수집 완료로 status 컬럼을 1로 바꾸고, 리뷰 분석(PLAi)·판매량 추정(ECSM) 파이프라인으로 넘긴다.
- 저장되지 않았으면 최대 3회까지 다시 요청하고, 3회를 넘기면 수집 불가(초과 실패)로 status 컬럼을 2로 바꾼다.
- 수집 중(0)인 상품은 상품 조회·판매량 조회 API가 503 Service Unavailable(수집 중인 상품입니다. 잠시 후 다시 시도해주세요.), 수집 불가(2)인 상품은 503 Service Unavailable(수집 실패한 상품입니다. 재등록해주세요.)로 안내한다.
- 개발 전에 플레이오토에 제공할 API마다 입력 검증 → 분기 → 응답 코드·오류 문구 → DB 상태 변화까지 Flow Chart로 설계하고, 관계사와 합의한 뒤 구현에 들어갔습니다.
- 상태 컬럼(시도 중 · 완료 · 재시도 초과)으로 수집 진행을 추적하고 30초 간격 3단계 재시도를 두었으며, 재시도 레벨별 건수를 기록해 실패 원인을 분리했습니다.
결과
- 1만 건 부하 테스트에서 API 요청 실패 0건. 사전 설계 덕분에 배포 후 발견된 연동 버그는 2건, 문서 공유 후 사용법 문의는 1건이었습니다.
8개 쇼핑몰 상품 URL을 하나의 식별 기준(mall + mall_pid)으로 정규화
어떤 고민이 있었는가
- 같은 상품인데도 들어오는 URL이 매번 달랐습니다. 검색어·광고·캠페인 파라미터가 붙고(?nl-query=, &buyboxtype=ad, sourceType=CAMPAIGN), 같은 쇼핑몰 안에서도 경로가 갈리고(11번가 /products/pa/, 롯데온 /product/bundle/), 파라미터 이름의 대소문자까지 섞여 있었습니다(지마켓 goodscode·goodsCode, 옥션 ItemNo·itemno).
- 그대로 저장하면 같은 상품이 중복 등록되고, 수집 엔진에는 식별이 안 되는 URL이 전달돼 수집이 실패했습니다.
어떻게 해결했는가
- 쿠팡·스마트스토어·11번가·지마켓·옥션·롯데온·SSG·GS샵의 URL 18가지 사례를 모아 쇼핑몰별 상품 ID 추출 규칙과 URL 저장 패턴을 설계했습니다.
- 상품 ID는 쇼핑몰마다 다른 위치에서 뽑습니다 — 경로 세그먼트(11번가·롯데온), 쿼리 파라미터(지마켓·옥션·SSG·GS샵), 두 값의 조합(쿠팡 상품ID.itemId, 스마트스토어 스토어명/상품ID).
- 저장 URL은 상품을 특정하는 최소 형태만 남기고 추적·광고 파라미터는 제거합니다. 단, 11번가 아마존 경로나 롯데온 번들처럼 경로 자체가 의미 있는 경우는 원본을 유지합니다.
- (mall, mall_pid) 조합에 UNIQUE 제약을 두어 중복 등록을 DB 수준에서 막았습니다.
결과
- 어떤 경로로 들어온 URL이든 같은 상품은 같은 mall_pid로 수렴해 중복 없이 한 번만 수집·저장되고, 등록 API는 식별 불가 URL을 400으로 즉시 걸러냅니다.
상품 n개를 n번 호출하지 않도록 다건 조회·삭제 API 설계 (partial_success)
어떤 고민이 있었는가
- 플레이오토는 상품 pk를 콤마로 묶어 한 번에 여러 건을 조회합니다(pk=223,269,273). 그런데 하나만 없거나 아직 수집 중이어도 전체를 404·503으로 돌려주면, 성공한 데이터까지 버려지고 어떤 pk를 다시 요청해야 하는지도 알 수 없었습니다.
- 실패 사유도 하나가 아니었습니다 — 등록되지 않은 pk, 삭제된 pk, 수집 중(status 0), 수집 실패(status 2)가 한 요청에 섞여 들어옵니다.
어떻게 해결했는가
- Start: 플레이오토가 상품 pk를 콤마로 묶어(pk=223,269,273) API를 요청한다.
- 숫자와 콤마 형식이 아니면 400 Bad Request(올바른 pk 형식이 아닙니다.)로 응답하고 종료한다.
- api_master의 status와 product_master의 상품 데이터를 조회한 뒤 pk마다 개별 판정한다.
- 등록되지 않은 pk는 404(해당 수집 상품이 존재하지 않습니다.), 수집 중(status 0)은 503(수집 중인 상품입니다. 잠시 후 다시 시도해주세요.), 수집 실패(status 2)는 503(수집 실패한 상품입니다. 재등록해주세요.)로 fail_result에 담고, 수집 완료(status 1)는 success_data에 담는다.
- 성공·실패 건수를 집계해 모두 성공이면 200 OK(success), 일부 성공이면 200 OK(partial_success, success_data와 fail_result를 함께 응답), 전부 실패면 404 Not Found(등록되지 않거나 삭제된 pk입니다.) 또는 503으로 응답하고 종료한다.
- 처리 중 예외가 나면 어느 단계에서든 500 Internal Server Error(서버 오류)로 응답하고 종료한다.
- pk마다 개별 판정해 성공분은 success_data, 실패분은 fail_result(pk · status · message)에 나눠 담는 응답 구조를 설계했습니다. total_request_count · success_count · fail_count를 함께 내려 클라이언트가 따로 집계하지 않아도 결과를 판단합니다.
- 실패 사유를 pk 단위 상태 코드로 구분했습니다 — 없는 pk는 404(해당 수집 상품이 존재하지 않습니다.), 수집 중은 503(잠시 후 다시 시도해주세요.), 수집 실패는 503(재등록해주세요.). 전부 성공이면 success, 일부면 partial_success, 전부 실패일 때만 응답 자체를 404·503으로 돌려줍니다.
- 같은 응답 틀을 상품 조회·판매량 조회·리뷰 요약 조회·상품 삭제 4개 API에 공통 적용하고, 목록 조회에는 limit·offset 페이지네이션으로 상한을 두었습니다.
결과
- 일부 상품이 없거나 수집 중이어도 성공분은 그대로 쓰이고, 플레이오토는 fail_result의 status별로 재등록(수집 실패)·대기 후 재시도(수집 중)·제외(없는 pk)를 나눠 처리할 수 있습니다.
긴 리뷰에서 AI 태그가 비는 원인을 길이 테스트로 특정
어떤 고민이 있었는가
- 리뷰를 통째로 요약 모델에 넣을 수도 없었습니다. 1,000자가 넘거나 이모지·특수문자가 많은 리뷰는 태그가 아예 추출되지 않는 경우가 있어, 원인이 길이인지 내용인지부터 확인해야 했습니다.
어떻게 해결했는가
- 1,119자·1,004자 리뷰를 25~900자로 잘라 가며 Tag API를 반복 호출해 생성 여부를 기록하고, 리뷰 길이·특수문자별 태그 추출 실험으로 전처리가 결과에 주는 영향을 확인했습니다.
결과
- 약 500자 이하로 줄이면 태그가 생성되는 경계를 확인했습니다.